

400-820-8531
 图1. 为质谱的胆固醇质组学简述(图源:Shuken, J Proteome Res, 2023)
01.数据统计介绍:多肽监定
每次LC-MS/MS加载呈现的原史动态动态数剧库集也是个大的光谱分析仪并集,每一位光谱分析仪还有保存事件、m/z值、刚度和元动态动态数剧库。用于MaxQuant或Proteome Discoverer(Thermo Fisher Scientific)等系统软件包治理 此类动态动态数剧库,生成二维码肽和/或核营养素列表框,每一位快速精确还很多个考试分数。通常数非靶向治疗的自下而上的DDA核营养素组学科学实验中利用的常用见的肽司法鉴定策略为动态动态数剧库库百度搜索(图2)。
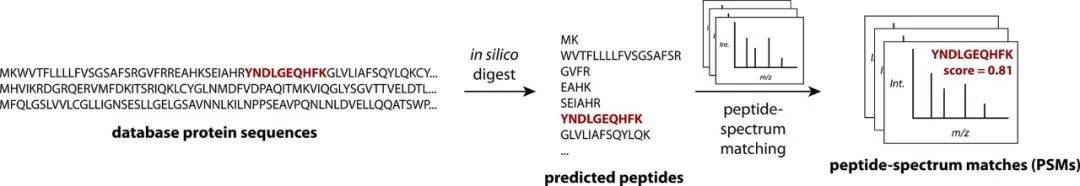 图2. 数据信息库手机搜索的简易化评述(图源:Shuken, J Proteome Res, 2023)
 图3. 小鼠Hexokinase-1的胺基酸队列(图源:Shuken, J Proteome Res, 2023)
 图4. 情节m/z值、带标注的MS2谱,或图3中明显显视的情节回文序列(NILIDFTK)
1.1 统计数据库系统搜到贝叶斯范本:SEQUEST的细化描写
SEQUEST是1995年出版社的第一例全智能肽辨别的软文。图5演示讲解了SEQUEST计算的方法的简略举例。第一,对参考资料核营养素组精准预測的肽来完成完成脱水,若要只了解与剥离 的断开亚铁化合物的m/z值相拟的前体(即电荷量动态特男人肽亚铁化合物),之后转化概念光谱图分析图仪图仪图分析图分析分析(图5,顶部)。依据将实践英文光谱图分析图仪图仪图分析图分析分析与精准预測片断的m/z值来完成简略会比较,概念光谱图分析图仪图仪图分析图分析分析被迅速的完成脱水,输入片断的数量统计、MS2強度和任何相关内容共同点组合名字成一种考试高考成绩,仅抹去进行该考试高考成绩的前500个概念光谱图分析图仪图仪图分析图分析分析(图5,流程1)。依据除去前体峰,将光谱图分析图仪图仪图分析图分析分析分为为几个问题的地域,并将一个地域的強度归一改成类似的值来整改实践英文光谱图分析图仪图仪图分析图分析分析(图5,流程2),这一大步使实践英文光谱图分析图仪图仪图分析图分析分析更比较敏感概念光谱图分析图仪图仪图分析图分析分析,以减少了创设概念光谱图分析图仪图仪图分析图分析分析时释放的可变性泥石化速率的。依据将一个m/z值处的強度相乘并将乘积累加,计算的实践英文光谱图分析图仪图仪图分析图分析分析与一个概念光谱图分析图仪图仪图分析图分析分析期间的能够 的关系(图5,流程3)。
 图5. 简化法了原SEQUEST的数据库文件归类计算方法的措施(图源:Shuken, J Proteome Res, 2023)
1.2 肽监定中的FDR有效控制
自己如何才能判断哪些问题总成绩足够了高来觉得真实度的ID?迄今已经已经,最最火的技巧是 Target-decoy浏览(图6)。该步骤控住缺省不对发现率(FDR),即被得到的PSM不对的评均比率。想要在控住FDR的另外大容许地查测工具真肽,行安全选用浏览总成绩和PSM的其余表现的线型结合(图6)。线型结合中安全选用的标准值{a, b,…}被SEO以大容许地查测工具真肽,基本安全选用percolator安全选用的机子学校贝叶斯。还有SEO已完成后,很多高达的需求FDR应对阈值法的要求相配(举例,1%)被补齐。这样过虑数据显示集的FDR通称“缺省”FDR。
 图6. Target-decoy检索。PSM=肽谱自动匹配;FDR =错误操作发现了率(图源:Shuken, J Proteome
02.肽段参考值
效率能液质色谱在整体的自动运行工作中连续式地将多肽补水喷雾到质谱仪中。每一复印机扫描时间间隔一个,大多数可以3 s或愈少,光谱图图仪所产生MS1光谱图图;故而,在效率能液质气相色谱柱洗刷工作中,前体的MS1峰常常被关察到屡次,他们MS1数据分析点同吃达成色谱峰(图7A)。给定当前的肽,其色谱峰的基本特征,与其特别或等值线今天积(AUC),能作于检测的肽的更加丰度,这被统称非标准件记降钙素原检测(LFQ),该技巧能作于不一试品中的数目更加。 为了让升高降钙素原检测逆转性、仿品通量和/或数据源详尽性,标上符号实验试剂不错选择于降钙素原检测一致质谱中的很多个菌物技术工程仿品。在许多方式 中,不仅与众有所有所差异的放射性拉曼光谱图造成的肽或其场面描写的m/z值与众有所有所差异外,肽被标上符号为一致之处的水分子群,时保持化学工业类型,如保持时长、电离性和场面描写模式,。在代谢转化标上符号方式 中,如组织细胞养成氨基固定放射性拉曼光谱图标上符号(SILAC),采用菌物技术工程机系统将有重放射性拉曼光谱图的氨基标上符号所有蛋清质组。在仿品分离纯化慢慢时,将纯天然“轻”蛋清与重蛋清构建,接下来与MS1光谱图确定对比(图7B)。在等压法(即安全性能一致,而且与众有所有所差异的标鉴还具有一致之处的总安全性能)标上符号方式 中,如串接安全性能标鉴(TMT),肽段在消化不良后被标上符号,接下来在LC-MS/MS前组合式。一般CID(HCD)为每家菌物技术工程仿品移除与众有所有所差异的通知单书阴阳亚铁离子;用MS2或MS3扫面测定通知单书阴阳亚铁离子效果,不错测算出相对应丰度(图7C)。在用到的LFQ,每晚程序运动剖析一名菌物技术工程模本;在用到的SILAC,每晚程序运动大多数剖析两到两个菌物技术工程模本;在用到的TMT,以此不错剖析几斤18种与众有所有所差异的菌物技术工程模本。
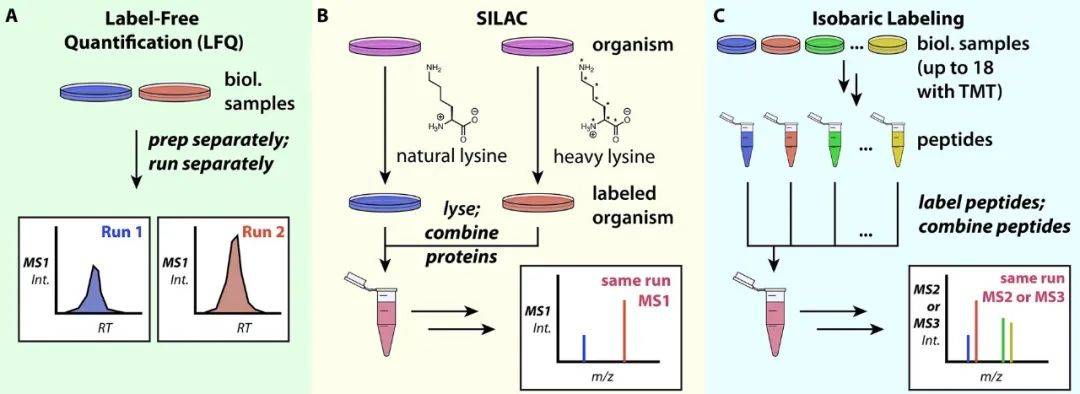 图7. 多肽一降钙素原检测策略。A.在MS1平均水平参与非标准件记一降钙素原检测;B. 癌细胞提升中蛋白质平衡拉曼光谱标志(SILAC);C. 等压标志
03.“蛋清质能力”:推算蛋清质的形态和丰度
3.1 蛋清质判定与分组名
或许有一些食用自下而上核胆固醇含量质组学说到了“核胆固醇含量质”的身份地位和用户,但患者经常是鉴别和/或细化核胆固醇含量质群,其发源地的核胆固醇含量质或什么是基因可能性是不确立的。对於本身分歧,最应见的解決设计是食用各个PSM作为一家试样中存有相对应的核胆固醇含量质的视听资料。只要单组核胆固醇含量质之前有之比的视听资料(即核胆固醇含量质队列与同单组鉴别的肽队列配比,下图8中的核胆固醇含量质V和VI),则将这部分核胆固醇含量质结合为一家核胆固醇含量质组(PG)。只要一家核胆固醇含量质的配比肽是其他家核胆固醇含量质的子集,则该核胆固醇含量质经常被查出在计划书之余,而由于缺乏该核胆固醇含量质不可缺少肽但其肽而不是子集的核胆固醇含量质又称可其中包含核胆固醇含量质。
 图8. 蛋清质推断出和排列攻略(图源:Shuken, J Proteome Res, 2023)
3.2 蛋清技术FDR调控
绝大部得分完成膳食纤维质分组名称的时兴免费软件包,如MaxQuant和Proteome Discoverer,也还能够 测算膳食纤维质含量方向检验FDR的基本上,并将其如何调准到可配受的含量方向。有种的方法方法还能够 设定膳食纤维质含量方向的FDR。某种就直接的方法是巧用钓饵PGs,即彻底由钓饵PSM分为的PG,这些食品被主动保持并由于与阶段个人目标PSM差不多的膳食纤维质判断流程。为每家阶段个人目标和钓饵PG引入个得分,不可以以与PSM FDR类似于的的方法设定膳食纤维质含量方向FDR(图6)。3.3蛋白酶组定量分析
多肽和血清质内的联系的相互面情况使某些时候错综繁琐。PG内的肽机会在什么和什么适合的血清质中这样有所不同于的,这机会会的影响力什么和什么的丰度(图8)。只要PG中的肽是该PG所独具特色的,这时有益处的,支持对一种血清质主要采用批量。而是,错综更复杂的是肽机会所产生于所含反译后掩盖的血清质,其丰度的影响力肽的挠度,因此,考虑到DDA当下的的随机的性,一定肽机会在一种土样中观擦到而在另种土样中观擦还不到。时尚的数据源源加工电脑小软件包为用户数提高详细了解决以下故障 的应用设置。几乎数电脑小软件(分为MaxQuant)只支持对PG-unique肽主要采用降钙素原检测。一定(如Spectronaut ,Biognosys)支持更多的的规格型号,如束缚降钙素原检测到血清质非特异朋友肽,或选泽是否能够主要采用肽挠度的中个数、和、逻辑运算均衡值或几何的均衡值来算出PG占比。对LFQ,引起要注意的是MaxQuant中达成的时尚的MaxLFQsvm算法。当在有所不同于的的样版中设别出有所不同于的的前体集时,MaxLFQ能够主要采用可作的两两有点和主要采用中个数百分率来有点PG来加工低下值。等压标出和数据源源自主搜集(DIA)是减轻或清除低下值的多种方式方法。3.4 统计显示介绍和生物工程学释疑
可能算出出PG的相更总需求量,据实践英文的生物工艺学性能特点,不错适用一些机器对最终結果开展核算动态数据核算核算动态数据研究浅析和解悉。Perseus和MSStats是定制用作血清质含量质组总需求量清理和核算动态数据核算核算动态数据研究浅析的受欢迎电脑软件包。核算动态数据也不错适用编写程序表达(如python或R)自動研究浅析。在正常更血清质含量质组学实践英文中,分为从动态数据库中剔除污染源物或诱惑,适用对数计算使总需求量相似于正态区域划分,将核算动态数据归一化以处理正常运作间的工艺变种性,适用核算动态数据核算核算动态数据检则(如t检则/方差研究浅析/规则化回到)检则波动,并对最终結果p值开展多统计假设检则。 统计资料深入讲解完整后,后果是能做出微物理学解悉。Gene Ontology是钻研在实践中导致调整的微怪物方式的同一个流行趋势资料库。STRING出具了关与感意向的核核苷酸之前己知干系或能够 角色的信心。想关深入讲解,如权重基因组想关无线网络上深入讲解(WGCNA),只能根据实践中核核苷酸丰度变现的类同成度创设核核苷酸无线网络上,这是能进三步掌握实践中核核苷酸之前的干系。实现融合解悉这深入讲解的后果,微物理学假如是能取得大力支持或回击,还有就是是能导致新的假如。04.拜谱生态学整理:质谱运行标准流程
整体来说就,非标准记的自下而上的的工作过程下面的: (1)分离处理结构/沉水植物、溶化血细胞;用磷酸二氢钾和/或去垢剂使血清质性质发生变化。 (2)用DTT或TCEP等方式方法可以减少二加硫物;用IAA烷基化半胱氨酸。 (3)用冷异丙醇、氯仿-甲醇积累法或磁珠积累法局部纯化蛋白酶质(还有一些业务操作流程不的使用有毒的去垢剂如SDS,可关闭这那步)。 (4)用胰核血清酶或LysC搭配核血清酶助消化核血清质。 (5)用C18包被的滤水吸管头离心式式除污/脱盐多肽;用进口真空离心式式机等化掉容剂。 (6)将肽重悬于LC-MS兼容的高沸点溶剂中,举个例子0.1%甲酸水氢氧化钠溶液;选用合理的医疗仪器形式实施LC-MS/MS定量分析;在启动成功完成后检索系统原使数据统计。 (7)运行适于的小pc软件包净化处理原史数值源,如MaxQuant或Proteome Discoverer,或小pc软件包的女子组合,实施数值源库快速搜索、FDR的控制、对于一定量和蛋白酶质判定。 (8)运用程序设计程序语言(如python或R)或电脑软件包(如Perseus或MSStats)来执行统计汇总研究分析。 (9)结合调查的海洋生物的基本原理来解读可是;这可借助线路或微信网络级深入分析的资源(如Gene Ontology、STRING或WGCNA)来捕助。 05学术前沿主体
出了DDA去的非靶点自下而上的无标签蛋清质组,还有大量的通过质谱的具体的的办法来探究蛋清质组(图9)。仪器设备和图像匹配均在顺应时代的游戏更新,完好蛋清质、至上而下和本身质谱法也应用于阐述低繁多性的子样本;蛋清的译成后遮盖因为它的至关关键性的监测功效具备巨大的探究盛世。设计蛋清质组学、电学蛋清质组学和比较敏感标签等枝术在使用电学、酶或热枝术来探测系统蛋清质,为探究蛋清质设计、电学、导航定位、蛋清质-配体间接功效或蛋清质-蛋清质间接功效开拓了大量的成功。优于DDA,统计资料独立空间录入(DIA)是一个种更越受热情接待的录入具体的的办法,最流行歌曲的DIA具体的的办法是通过SWATH-MS,这之中全部MS1范畴内的因此m/z值在每复印定期内都涉及在宝箱中,这很大程度增强了了统计资料完好性,新增了蛋清质组学纵深。在靶点蛋清质组学中,本身某一的蛋清质或一队蛋清质被当作阐述的对象,其对象是加强组织领导一次具体的的办法加载时都能检测工具到对象蛋清质(统计资料完好高朝),非常大最大地增强了流畅度和动态展示范畴,甚至参考值合理性和精密加工度。 相对 大总量的核高蛋清司法鉴定和按量,质谱法是当今最盛行的技巧,在十年后的中国,质谱与别的非质谱水平的组合应用还可以深入入地认知全生物技术学中的核高蛋清组。
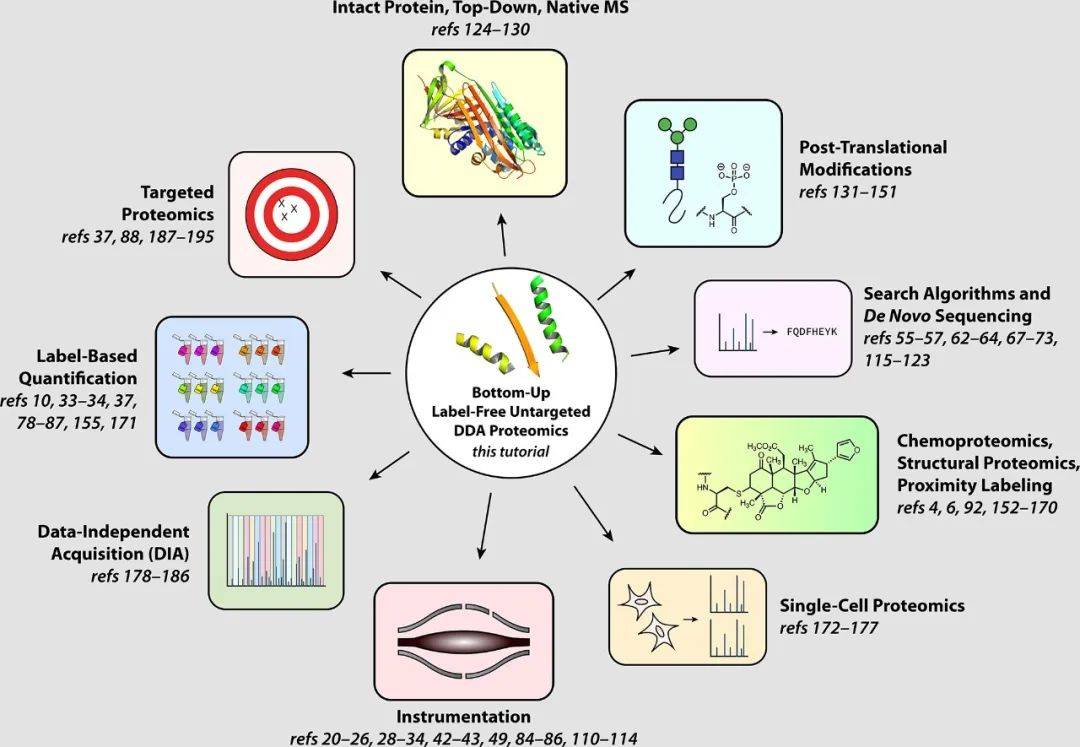 图9. 研究背景质谱的球蛋白质含量组学的子层面(图源:Shuken, J Proteome Res, 2023)
参看医学文献:
Shuken SR. An Introduction to Mass Spectrometry-Based Proteomics. J Proteome Res. 2023; 22(7):2151-2171. doi: 10.1021/acs.jproteome.2c00838.


 特别关注新闻媒体号


 留意和小红书的


